🔍 RAGとは?LLMに「知らない情報」を検索させる仕組み
ChatGPTのような大規模言語モデル(LLM)は膨大な知識を持っていますが、社内マニュアルや個人の資料、頻繁に更新される商品情報など、モデルが学習していない情報を自動的に知ることはできません。そこで利用されるのが「RAG(Retrieval-Augmented Generation:検索拡張生成)」です。RAGでは、ユーザーの質問を受け取ると外部の文書群から関連情報を検索し、その内容をコンテキストとしてLLMに渡して回答を生成します。この考え方は2020年に発表されたRAG研究でも体系化され、モデル内部の「パラメトリックな記憶」と、検索可能な外部の「非パラメトリックな記憶」を組み合わせる方法として提案されました。現在ではAIチャット、社内文書検索、カスタマーサポート、AIエージェントなど幅広い用途に発展しています。
🧩 「RAG=ベクトル検索」は誤解?まず全文検索から試すという考え方
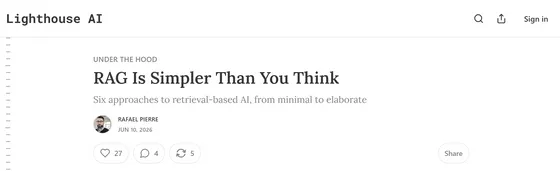
AIエンジニアのラファエル・ピエール氏は、2026年6月に公開した「RAG Is Simpler Than You Think」で、RAG開発者が最初から埋め込み(Embedding)、ベクトルデータベース、リランキングといった複雑な技術を導入する「オーバーエンジニアリング」に陥りやすいと指摘しています。ピエール氏が最初に推奨するのは、意外にもAI以前から使われてきた全文検索です。BM25やPostgreSQLの全文検索などを利用すれば、「RTX 5070」「エラーコード0x1234」「商品番号ABC-001」のように文字列そのものが重要な質問では、意味検索より正確に目的の情報を発見できる場合があります。PostgreSQLにも文書解析、ランキング、同義語辞書、インデックスなど本格的な全文検索機能が標準で用意されています。
ここから検索精度が不足した場合に、必要な機能だけを段階的に追加していくのがピエール氏の考え方です。代表的な6段階を整理すると次のようになります。
- 🔎 ① 全文検索:BM25などでキーワードを直接検索。型番・固有名詞・専門用語に強く、低コストで高速。
- ✍️ ② クエリリライト:LLMが質問を検索向けに変換。「コードを速くしたい」→「コード 高速化 最適化 パフォーマンス」のように語彙のズレを補正。
- 🧠 ③ ハイブリッド検索:全文検索で候補を取得し、埋め込みによる意味の近さも利用して候補を並べ直す。
- ⚡ ④ オンデマンド埋め込み:検索候補だけをその場でベクトル化。ニュースなど更新頻度の高い情報に適する。
- 🔥❄️ ⑤ Hot/Cold方式:頻繁に利用される文書だけ事前にベクトル化し、利用頻度の低い文書は必要時に処理。
- 🗄️ ⑥ 全文書の事前埋め込み:すべてをベクトル化して保存し、大量アクセスに対して高速な意味検索を実現。
🧠 「検索語を書き換えるだけ」でRAGが大幅に改善することも
特に興味深いのが2段階目の「クエリリライト」です。たとえばユーザーが「プログラムが重いから軽くしたい」と入力しても、技術文書には「performance optimization」としか書かれていないかもしれません。そこでLLMが質問の意図を理解し、「performance optimization」「高速化」「処理時間」といった検索語へ変換してから従来型検索に渡します。MicrosoftのRAG設計ガイドでも、略語の展開、俗語の除去、質問の再構成、複雑な質問のサブクエリへの分解などが高度なRAGの前処理として紹介されています。さらに「CSVを読み込み、欠損値を処理してグラフを作るには?」という質問なら、「CSV読み込み」「欠損値処理」「グラフ作成」の3検索に分解して並列処理し、最後にLLMが統合する方法も考えられます。つまりRAGの性能向上は、検索エンジンそのものを巨大化するだけでなく、「何を検索するべきなのか」をLLMに考えさせる方向にも進んでいるのです。
⚡ ハイブリッド検索が強い理由――キーワードと「意味」を両方使う
全文検索にも弱点があります。「自動車」と検索した時に「クルマ」「automobile」としか書かれていない文書を見落とす可能性があるためです。そこで使われるのが、文章を数値ベクトルへ変換する「埋め込み」と意味検索です。ただし、意味検索だけに切り替える必要はありません。現在のElasticsearchなどでは、キーワード検索とベクトル検索を同時に実行して結果を統合するハイブリッド検索が正式にサポートされています。たとえばRRF(Reciprocal Rank Fusion)では、BM25とベクトル検索という異なるランキングを統合し、「文字列として一致する情報」と「意味として近い情報」の双方を評価できます。さらに候補を少数まで絞ってから高性能なモデルでリランキングすれば、計算量を抑えながら検索品質を高められます。
一方、埋め込みを導入すると新しい問題も生まれます。長い文書を何文字・何トークン単位で分割するのか、チャンク同士をどの程度重複させるのか、見出し単位で分割するのか、といった「チャンク設計」が必要になるためです。さらに文書が頻繁に更新される環境では、ベクトルも更新しなければ古い検索結果が残ります。そこでニュースやSNS、問い合わせ履歴など更新頻度の高いデータでは、全文検索で20~50件程度まで候補を絞り、その候補だけを検索時に埋め込む方法が有力になります。逆に大量アクセスされる安定した文書群なら、あらかじめ全データを埋め込んでおく方が高速です。つまり**「どのRAGが最も高度か」ではなく、データの更新頻度・検索回数・必要な応答速度によって最適解が変わる**わけです。
🚀 まとめ:RAGの重要ポイントは「複雑にする前に測定する」
ピエール氏が示した経験則では、RAGシステムの約60%は「全文検索+クエリリライト」で十分、約25%がオンデマンド埋め込みやHot/Cold方式を含むハイブリッド検索、約10%が全文書の事前埋め込み、残り約5%だけが独自の高度な構成を必要とするとされています。これは統計調査ではなく同氏の経験に基づく目安ですが、重要なのは最初から最高に複雑なRAGを作るのではなく、検索ログやユーザーの失敗例を見て次の技術を追加するという考え方です。同氏はまずBM25を構築し、実際の検索品質を測定し、不足するならクエリリライト、それでも意味的な検索能力が足りなければハイブリッド検索へ進むという順序を提案しています。生成AIが高性能になるほど、RAGの競争軸も「巨大なベクトルDBを持っているか」ではなく、質問を正しく理解し、必要な情報だけを安価かつ高速に取得して、根拠としてLLMへ渡せるかへ移っているといえるでしょう。
📚 参考・出典
- Lighthouse AI「RAG Is Simpler Than You Think」
- Microsoft Learn「Build Advanced Retrieval-Augmented Generation Systems」
- Elastic「Hybrid search」
- PostgreSQL Documentation「Full Text Search」
- 原論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」