AMDは2026年8月27日、GPU計算ソフトウェアスタックの最新版「ROCm 10」を公開しました。ROCmはAMD製GPUでAI学習・推論・科学技術計算などを実行するための基盤で、NVIDIAのCUDAに対抗する存在として長年開発されてきました。今回のROCm 10では、ライブラリやコンパイラの改良だけでなく、**AIエージェント自身にAMD環境の構築・診断・最適化を任せる「ROCm.AI」**が正式提供された点が大きな特徴です。さらにComfyUI向けにWan2.2、FLUX.2 KLEIN、Stable Diffusion 3.5 Medium、SDXLなどの生成AIワークロードも最適化されており、AMDは単なる「CUDA互換の計算基盤」から、AIエージェントがソフトウェア最適化まで担う開発環境へROCmを進化させようとしています。AMDによれば、同一ハードウェア上でROCm.AIを用いた構成はROCm 7比で平均3.3倍の推論性能、2.4倍の学習性能向上を示したとしていますが、これは特定のAMD検証環境に基づく数値であり、すべてのモデルやGPUで同じ倍率になるわけではありません。
🚀 ROCm 10とは?「CUDA対抗」だけではなくAI開発そのものを自動化
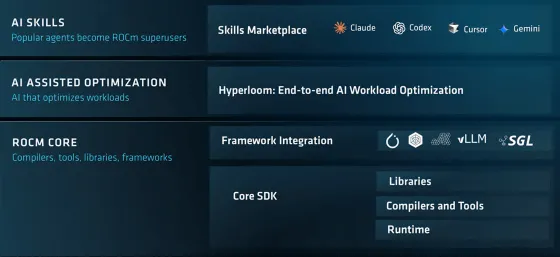
AI分野ではPyTorchや各種推論エンジン、カスタムCUDAカーネルなどNVIDIA向けに最適化されたソフトウェア資産が膨大に存在しており、AMD GPUは理論性能やVRAM容量で競争力があっても、実際のAI処理ではソフトウェア対応によって性能差が生じるケースがありました。ROCm 10では、この弱点を単純なCUDA追随だけで解決するのではなく、よりモジュール化されたROCm Core SDK、ライブラリ、コンパイラ、通信基盤、AIフレームワーク対応に加え、AIエージェント自身に「AMDでどう動かすべきか」を判断させる仕組みを前面に押し出しています。ROCm.AIを構成する中心要素は「AMD Skills」「ROCm CLI」「ROCm Hyperloom」の3つで、開発者がROCmの膨大なドキュメントを読みながら手作業で環境を調整する従来型の開発から、AIに診断・提案・最適化を委任する方式へ移行しようとしているのが特徴です。
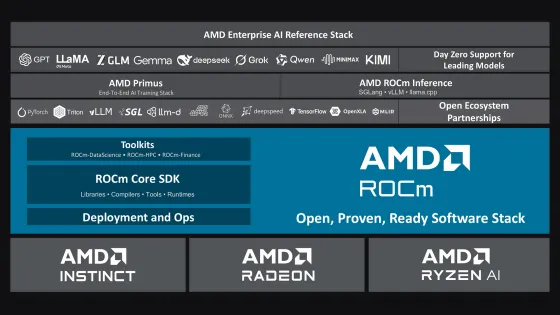
ROCm 10の主要な強化点を整理すると、次のようになります。
- 🤖 ROCm.AI:AIエージェントを使ったAMD向け開発・最適化環境
- 🧩 AMD Skills:Codex、Claude Code、CursorなどへAMD公式の作業知識を追加
- ⚙️ Hyperloom:推論ワークロードを解析し、自動でコードや設定を最適化
- 🖥️ ROCm CLI:環境確認や診断などをエージェントから扱いやすくするCLI
- 🎨 ComfyUI最適化:Wan2.2、FLUX.2 KLEIN、SD3.5、SDXLなどを性能チューニング
- 🧠 LLM推論・学習基盤の改良:vLLMやSGLangなどの実運用ワークロードを強化
- 🔗 通信ライブラリ強化:RCCLやrocSHMEMなど、大規模GPUクラスタ向けの性能・機能改善
特にRCCLやrocSHMEMといった複数GPU間通信には大規模な投資が行われ、AMD自身もNVIDIAのNCCLやNVSHMEMとの機能差を縮めることをROCm 10の重要テーマとして挙げています。これは数台の家庭用GPUというより、MI300XやMI350世代を数十~数千基接続するAIデータセンター市場を意識した改良です。
🧩 「AMD Skills」はCodexやClaude Codeに“AMDエンジニアの手順”を教える仕組み
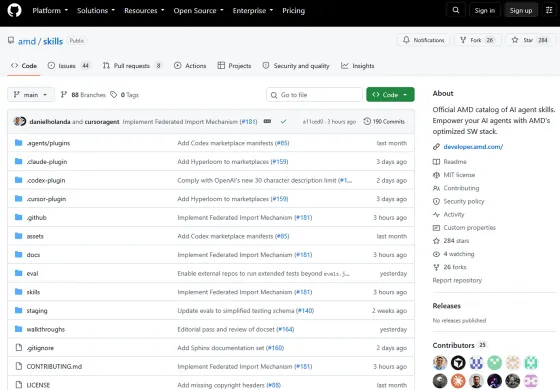
ROCm.AIの中でも一般ユーザーにとって分かりやすいのが「AMD Skills」です。これは単なるドキュメント集ではなく、AIコーディングエージェントが必要な場面で読み込む再利用可能な作業手順です。AMD公式GitHubではSkillを「特定のタスクを実行するための指示、スクリプト、プロンプト、テンプレート、参考資料をまとめた自己完結型フォルダ」と定義しており、中心にはSKILL.mdというファイルがあります。Codex、Claude Code、Cursor、Gemini CLIなどがタスク内容を見て関連Skillを選択し、必要な手順だけを読み込む仕組みです。たとえば「AMD InstinctでLLM推論サーバーを立てて」と依頼すれば、対応SkillがGPU検出、モデルのVRAM適合性確認、vLLM設定、ベンチマークまで一連の手順を案内できます。
ここが従来のドキュメントとの大きな違いです。ドキュメントは「使えるすべてのオプション」を中立的に説明しますが、SkillはAMDのエンジニアならどのオプションを選び、どの順番で確認するかという“推奨ルート”まで含めることができます。公式カタログにはローカルAI利用、AMD InstinctでのLLMサービング、ROCm診断、ワークロード解析などのSkillが用意・計画されており、Codexでは$HOME/.agents/skillsまたはプロジェクト内.agents/skillsへ配置可能です。これは最近広がっている「Agent Skills」方式そのものであり、AI開発ではモデルの賢さだけでなく、企業が自社ハードウェア向けの正しい作業知識をエージェントへ直接提供する競争が始まったとも言えます。
🤖 Hyperloomは「測定→修正→再測定」をAIが自動ループする
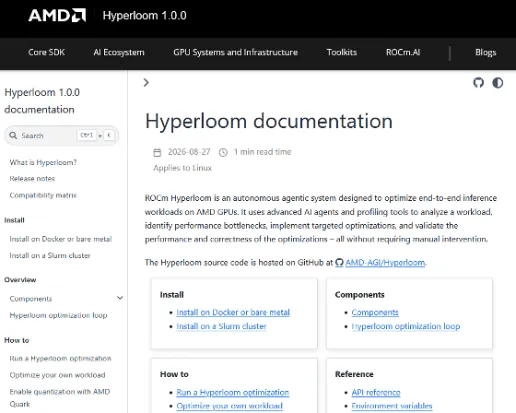
ROCm.AIでさらに野心的なのが「ROCm Hyperloom」です。HyperloomはAMD GPU上で動く推論ワークロードをプロファイリングし、ボトルネックを発見し、設定やコードを変更し、ベンチマークを実行し、性能と正しさを検証するところまでを自動化するエージェントシステムです。処理は単発の「AIにコードを書かせる」ものではなく、Think → Decide → Implement → Benchmarkという最適化ループを繰り返す構造になっています。内部ではワークロード解析、フレームワークレベルの最適化、カーネル最適化、パラメータ探索などを段階的に行い、改善余地が残っていれば再び解析フェーズへ戻ります。AMDによれば、従来はGPU性能エンジニアが何日~何週間もかけていた作業を、長時間稼働するAIエージェントへ委任することを狙っています。
Hyperloomで自動化される流れは、おおむね以下のようになります。
- 🔍 Profile:GPU使用率やカーネル、メモリ転送を測定
- 🧠 Analyze:性能ボトルネックを特定
- 💡 Explore:改善候補をAIが検討
- 🛠️ Implement:設定変更やコード修正を実施
- 📊 Benchmark:変更後のスループットを測定
- ✅ Validate:出力結果が壊れていないか確認
- 🔁 Repeat:改善余地があれば再びループ
vLLMやSGLangを使ったLLM推論にも対応し、HIP、Triton、FlyDSLなど複数のレイヤーを最適化対象にできます。さらにMI300X、MI325X、MI355X向けには、3時間程度の軽い探索から12時間かけてカーネル書き換えまで行う長時間キャンペーンも公式Skillとして用意されています。興味深いのは、一部のカーネル操作はLLMに直接コードを書かせるのではなく、Python側の専用ハンドラを介して実行するなど、安全性と再現性を考慮した設計になっている点です。
🎨 ComfyUIも強化、Wan2.2・FLUX.2 KLEIN・SDXLなどをAMD向けに最適化
ROCm 10はデータセンター向けLLMだけでなく、画像・動画生成ユーザーにも直接影響します。AMDはComfyUI向けの最適化を拡大し、Wan2.2、FLUX.2 KLEIN、Stable Diffusion 3.5 Medium、Stable Diffusion 2.1、Stable Diffusion XL Baseなどを性能チューニングしたと発表しています。さらにattentionアルゴリズムやバックエンドの選択方法についてもAMD公式ガイドを整備しており、以前のようにユーザーがGitHubや掲示板を巡回しながら「AMDではどのattention実装が速いのか」を試行錯誤する負担を減らす方向です。ROCmの公式ComfyUI環境ではWan2.2のテンプレートも整備されており、AMDは画像生成だけでなく、大量のVRAMと演算量を必要とする動画生成も重要なワークロードとして扱っています。
この強化は一般ユーザー向けAMD GPUにとっても重要です。AMDは2026年時点ですでにWindowsネイティブROCm環境でComfyUIを動かす手順を公開し、Ryzen AI Max+ 395のRadeon 8060Sでは統合メモリを利用してWan2.2の大型ワークフローを実行するデモも行っています。この例では約42GBものGPUアクセス可能メモリを使用しており、一般的な8~24GBの単体GPUでは収まりにくいモデルを大容量統合メモリで動かせる点をアピールしています。ただしROCm 10で「AMD GPUなら何でも高速になる」という意味ではありません。対応OS、GPU世代、PyTorchビルド、attentionバックエンド、モデルごとの最適化状況によって差が大きく、特にWindowsとLinuxでは対応範囲も異なります。
⚔️ CUDAとの差は縮まるのか?ROCm 10の本当の勝負は「ソフトウェア資産」
AMDが直面している最大の壁はGPUそのものの性能だけではなく、CUDAが長年築いてきたソフトウェア生態系です。研究コード、AIライブラリ、企業内ツール、独自CUDAカーネル、開発者の経験まで含めると、CUDAには非常に大きな蓄積があります。2026年第2四半期のデスクトップ向け単体GPU出荷ではNVIDIAが約90%のシェアを持つとの調査もあり、コンシューマー分野でもAMDとの差は依然として大きい状況です。
だからこそROCm 10でAMDが選んだ「Skills+AIエージェント」という戦略は興味深いものです。人間の開発者全員にROCm固有のノウハウを一から覚えてもらうのではなく、CodexやClaude Code側にAMDの最適解を覚えさせてしまうことで、CUDAとの経験差を部分的に飛び越えられる可能性があります。将来「このPyTorchプロジェクトをAMD GPUで高速化して」と一言頼むだけで、エージェントが環境を診断し、AMD Skillsを参照し、Hyperloomでプロファイルし、カーネルを変更し、ベンチマークまで行うようになれば、GPUを選ぶ際の「CUDAしか分からないからNVIDIAを買う」というロックインを弱められるかもしれません。一方で、ROCmがCUDAの巨大な既存資産、互換性、安定性を短期間で完全に置き換えるわけではなく、ROCm 10の成否は今後どれだけ多くのモデル・GPU・OS・開発ツールで「そのまま動いて速い」という体験を提供できるかにかかっています。
🔎 まとめ:ROCm 10は「AMD GPUを速くする」だけでなく、AIに最適化作業そのものを任せる転換点
ROCm 10の重要性は、単純な推論速度の向上だけではありません。AMD SkillsによってCodexやClaude Codeへ公式ノウハウを渡し、Hyperloomがプロファイル・修正・検証を自動で繰り返し、ComfyUIでは画像・動画生成モデルをAMD向けに最適化する――というように、AIを動かすためのソフトウェアを、別のAI自身に構築・改善させる構造が本格化しています。NVIDIA CUDAとの差は依然として大きいものの、AMDが「CUDAと同じものを後追いする」だけでなく、エージェント時代に合わせて開発体験そのものを再設計し始めた点は注目に値します。特にCodexやClaude Codeを日常的に使う開発者にとっては、今後GPUのメーカー選びが「どちらのAPIを覚えているか」ではなく、エージェントがどちらの環境をどれだけ自動で扱えるかによって決まる時代に近づいているのかもしれません。
📚 参考・出典
- AMD Newsroom「AMD ROCm 10: Bringing ROCm.AI’s AI-Native Developer Experiences to AMD Platforms」
- AMD ROCm Blog「ROCm 10.0: A Decade of Open Compute, Built for the Age of Agentic AI」
- AMD「ROCm 10: A Simpler Path to Production AI on AMD Instinct GPUs」
- AMD公式GitHub「amd/skills – Official AMD catalog of AI agent skills」
- AMD ROCm Documentation「Hyperloom documentation」
- AMD ROCm Documentation「Hyperloom optimization loop」
- AMD Skills Documentation「hyperloom-workload-optimizer」
- AMD ROCm Documentation「ComfyUI on ROCm」
- AMD ROCm Blog「Local Image and Video Generation on AMD Ryzen AI Max+ Processor」
- Tom’s Hardware「Desktop graphics card shipments hit four-year high」