音楽ストリーミング大手のSpotifyが、AIコーディングエージェント「Claude Code」のトークン消費を大幅に削減する手法を公開しました。Spotifyのエンジニアであるディミトリ・マズマノフ氏は、大量のソースコードを読み込む作業や定型的なコード生成を軽量AIモデルに任せることで、検証したファイル読み込みタスクにおいて、Claude側のトークン消費を平均約90%削減できたと報告しています。注目すべきなのは、高性能AIの利用をやめるのではなく、複雑な推論はClaudeに任せ、単純な入出力処理は別のモデルに分担させるという設計です。この取り組みは、Claude Codeだけでなく、CodexやGemini CLI、ローカルLLMを組み合わせたAIエージェントの運用コスト削減にも応用できる考え方として注目されています。
🧠 なぜClaude Codeは大量のトークンを消費する?AI開発の隠れたコスト
Claude CodeのようなAIコーディングエージェントは、ユーザーから指示を受けると、関連するソースコードの調査、ファイルの読み込み、修正案の検討、コード生成、テストの実行などを繰り返します。しかし、数千行のソースファイルを丸ごと読み込んだり、既存のテストコードを大量に参照したりする作業では、必ずしも高度な推論が必要とは限りません。それでも、読み込んだ内容は高性能モデルのコンテキストに追加され、入力トークンとして消費されます。さらに、長い作業セッションでは過去のツール実行結果や生成コードも会話履歴に蓄積され、利用料金やコンテキスト容量を圧迫する要因となります。Spotifyのマズマノフ氏は、この問題を「AIに考えさせる作業」と「大量の情報を読み書きする作業」に分離することで解決しようとしました。高性能モデルには重要な判断に必要な情報だけを渡し、それ以外の処理を軽量モデルに委譲するという発想です。
⚡ Gemini 2.5 Flashを活用!bulk-readerとcode-writerで作業を分担
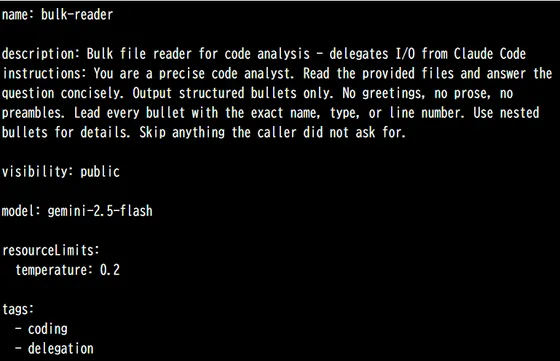
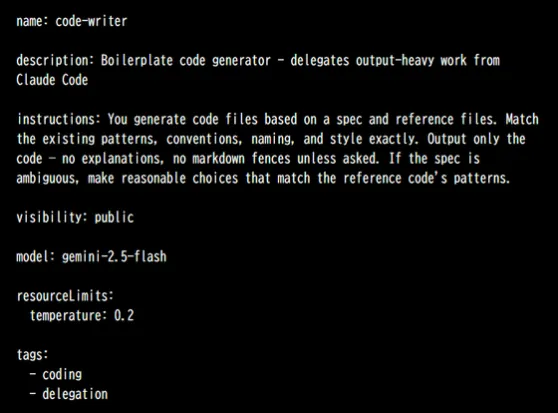
Spotifyが活用したのは、社内の開発者向けプラットフォーム「Portal by Spotify」に用意された「AiKA Modes」という機能です。AiKA Modesでは、使用するAIモデル、システム指示、温度パラメーター、MCPツールなどを宣言的に設定し、専用のAIエージェントとしてCLIやAPIから呼び出せます。マズマノフ氏は、この仕組みを使って「bulk-reader」と「code-writer」という2つの作業用エージェントを構築し、どちらにも比較的軽量な「Gemini 2.5 Flash」を指定しました。bulk-readerは大量のファイルを読み込み、Claudeが必要とする情報だけを短く要約する役割を担います。一方のcode-writerは、既存コードを参考にテストや設定ファイルなどを生成し、必要に応じてファイルへ直接書き込みます。これにより、Claudeは数千行のソースコードや大量の生成結果を受け取らずに済み、コンテキストの消費を抑えながら重要な判断に集中できます。
🔧 Spotifyが導入した2つの作業用AI
- 📚 bulk-reader(大量読み込み担当): 複数の大きなファイルを調査し、質問への回答に必要な情報だけをClaudeへ返す
- ✍️ code-writer(コード生成担当): 参考コードに沿ってテスト、型定義、設定ファイルなどを生成する
- 🧠 Claude Code(判断担当): アーキテクチャ設計、複雑なデバッグ、変更内容の検証などを担当
- 🔄 Portal CLI・API(実行基盤): 作業用AIを呼び出し、モデル間の処理を接続する
🛠️ Claude CodeのHooksで強制的に振り分け!「shunt」が無駄な読み込みを防止
Spotifyの手法で特に重要なのが、Claude Codeの「PreToolUse」フックを利用した自動振り分けです。当初はプロジェクトごとの設定ファイル「CLAUDE.md」に、単純作業を別モデルへ委譲するよう指示していましたが、Claudeが必ずしもその指示に従うとは限りませんでした。そこで導入したのが「shunt」というClaude Codeプラグインです。shuntはClaudeがファイルを読み込む直前に処理を確認し、デフォルトで350行を超えるファイルを丸ごと読み込もうとすると、その操作をブロックしてbulk-readerへの委譲を促します。catやhead、tailなどを使った大量の読み込みも検出する一方、必要な行だけを指定した読み込みや、検索によって対象を絞った操作は許可されます。フックが不要な大量読み込みを防ぎ、Skillが委譲方法を説明し、シェルスクリプトがPortal CLIを実行するという3層構造によって、単なるプロンプト指示より安定した制御を実現しています。
🔄 自動振り分けの流れ
- 🔍 Claudeが作業を開始: ソースコードの調査やテスト作成を判断
- 🛡️ shuntが操作を検査: 大きなファイルの読み込みを検出してブロック
- ⚡ 軽量AIへ委譲: Gemini 2.5 Flashが大量の情報を処理
- 📄 必要な結果だけを返却: Claudeには短い要約や処理結果を渡す
- 🧠 Claudeが最終判断: 複雑な修正や安全性の確認を担当
📊 トークン消費を平均90%削減!ただし高度な推論はClaudeが担当
マズマノフ氏はJavaのモノレポを用いて4種類のシナリオを検証し、Claudeが直接ファイルを読み込む場合と、bulk-readerを経由する場合を比較しました。その結果、Claude側の読み込みトークン消費は平均約90%削減されたと報告しています。ただし、この数字は検証した作業におけるClaude側の消費量であり、すべての開発タスクでAPI料金が90%安くなるという意味ではありません。実際には作業用モデルの利用料や追加の通信時間も発生し、委譲には通常10〜30秒程度かかるため、小規模なファイルでは逆に効率が低下する可能性があります。また、軽量モデルが表面的なコードの特徴を把握できても、スレッドセーフティーに関わる問題を見逃した事例があり、複雑なデバッグやアーキテクチャ設計、安全性が重要な変更はClaudeに任せる必要があるとされています。Spotifyは別の取り組みとして、Claude Agent SDKを大規模なコード変更基盤「Fleet Management」に統合しており、月間650件以上のAI生成プルリクエストを本番環境へマージし、複雑なコード移行に必要なエンジニアの作業時間を最大90%短縮したと報告しています。これは今回のトークン削減とは別の成果ですが、SpotifyがAIを単純作業の効率化と高度な開発支援の両方に活用していることを示しています。
📝 まとめ:高性能AIと軽量AIの役割分担がコスト削減の鍵に
Spotifyが公開した手法は、Claude Codeのすべての処理を高性能モデルに任せるのではなく、大量のファイル読み込みや定型コード生成を軽量AIに委譲することで、トークン消費を大幅に削減するものです。特に、Claude CodeのHooksを利用して不要な読み込みを自動的に防ぐ仕組みは、AIエージェントの運用を効率化するうえで参考になります。今後はCodexやClaude Code、ローカルLLMなどを用途に応じて組み合わせ、**高性能AIには判断を、軽量AIには大量処理を任せる「モデルルーティング」**が、AI開発のコストと品質を両立する重要な設計手法になっていくでしょう。
📚 参考・出典
- Spotify Engineering — Portal by Spotify cut my Claude Code token usage by 90%(2026年9月3日)
- Anthropic — Spotify Claude Agent SDK導入事例
- Anthropic公式ドキュメント — Claude Code Hooks
- Anthropic公式ドキュメント — Claude Code Skills
- GitHub — Spotify Portal AI Plugins
- Spotify Engineering — AI Changed How Spotify Builds. What We Learned (and Fixed) About Quality at Higher Velocity