🚀 NVIDIAが「Vera CPU」を自社の次世代チップ開発に本格投入
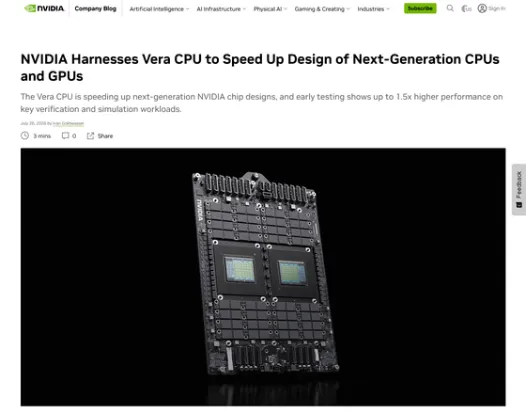
NVIDIAは、次世代データセンター向けCPU「Vera」を、自社のさらに次の世代のCPUやGPU、AIシステムを設計するための開発環境へ本格投入しています。半導体は世代を重ねるごとにトランジスタ数や回路構成、パッケージングが複雑になり、設計した回路が正しく動作するかを検証するだけでも膨大な計算が必要になります。そこでNVIDIAはCadenceやSynopsysと協力し、EDA(Electronic Design Automation:電子設計自動化)ソフトウェアをVera向けに最適化。初期テストでは重要な検証・シミュレーション処理で最大1.5倍の性能向上を確認しており、Veraを次世代CPU・GPU開発のEDAワークフロー全体へ展開しています。単純に「CPUが50%高速になった」という話ではなく、NVIDIA自身の新製品を市場へ送り出すまでの時間を短縮できる可能性があることが今回の発表の重要なポイントです。
半導体設計ではGPUによる並列計算やAI活用が急速に進んでいるものの、すべての処理をGPUへ移せるわけではありません。回路の論理検証やシミュレーションなどには、処理の分岐や依存関係が多く、依然としてCPUのシングルスレッド性能やメモリアクセス性能がボトルネックになる領域があります。EDA処理が高速になれば、エンジニアは同じ開発期間でもより多くの設計案を試し、より多くのバグや問題を製造前に発見できます。つまりVeraの高速化は「1回の計算が早く終わる」だけでなく、試行回数そのものを増やしてチップの完成度を高める効果が期待できます。GPUを高速化するためのCPUをNVIDIA自身が設計し、そのCPUでさらに次のGPUを設計するという“自己強化型の開発サイクル”が形成され始めています。
🧠 VeraはなぜEDAに強い? 88基の独自「Olympus」コアが鍵
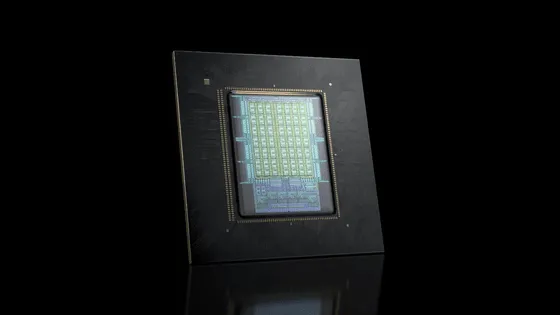
Veraは従来のGrace CPUとは異なり、NVIDIAが独自設計したArm互換の「Olympus」CPUコアを88基搭載します。Spatial Multithreadingによって176スレッドを実行でき、最大1.5TBのLPDDR5Xメモリと最大1.2TB/sのメモリ帯域を備えます。さらにCPUとGPU間を第2世代NVLink-C2Cで接続した場合、最大1.8TB/sのコヒーレント帯域を確保します。NVIDIAによるとLPDDR5Xメモリシステムは一般的なCPUメモリと比較して2倍の帯域を半分の消費電力で提供する設計で、EDAだけでなくAIエージェント、強化学習、データ解析などCPU側で大量のデータを高速処理する用途を狙っています。
Vera CPUの主な特徴を整理すると次の通りです。
- 🧠 88基のNVIDIA独自Olympusコア:Arm互換で高いシングルスレッド性能を重視
- ⚙️ 176スレッド:Spatial Multithreadingによって多数の処理を並行実行
- 💾 最大1.5TB LPDDR5X:大規模なEDA・AI処理に対応
- ⚡ 最大1.2TB/sのメモリ帯域:大量データをCPUへ高速供給
- 🔗 最大1.8TB/sのNVLink-C2C:Rubin GPUなどとの高速なCPU-GPU接続
- 🏭 EDAからAIファクトリーまで対応:チップ設計だけに特化したCPUではなく、AIエージェントやHPCにも利用可能
さらにNVIDIAの技術資料では、Veraはフルソケット負荷時の持続的なコア単位性能で比較対象CPUより最大1.8倍、ピーク負荷時のレイテンシを約40%削減し、コアあたりのメモリ帯域では3倍超という結果も示されています。ただし、これらはNVIDIA自身による特定条件での測定値であり、今回のEDAにおける「最大1.5倍」とは別のベンチマークです。実際の性能差はアプリケーションや構成によって変化すると見る必要があります。
🔧 Cadence・Synopsysとの協業が重要、EDA最適化は半導体開発そのものを変える
今回の動きでもう一つ重要なのが、CPUを作って終わりではなく、EDA大手のCadenceやSynopsysとソフトウェア側の最適化を同時に進めていることです。現代の最先端半導体はEDAなしでは事実上設計できず、論理設計、機能検証、物理設計、タイミング解析、電力解析など多数の工程をソフトウェア上で繰り返します。CPU性能が向上してもEDAソフト側が新しいアーキテクチャを十分活用できなければ性能は伸びないため、ハードウェアとEDAを共同最適化する意味は大きくなります。NVIDIAにとってはCUDAでGPUとソフトウェアを一体化してきた戦略を、CPUと半導体設計環境にも広げていると見ることができます。
特に注目すべきなのは「Time to Market(市場投入までの時間)」への影響です。例えば数時間~数日に及ぶ大規模検証を短縮できれば、開発チームは製品発売までに実行できるシミュレーション数を増やせます。設計→検証→修正→再検証というループが高速化すれば、単純な計算時間の短縮以上の効果が生まれます。NVIDIAがBlackwell、Rubinと短いサイクルで新しいGPUアーキテクチャを投入する戦略を続けるうえでも、EDAインフラそのものの高速化は重要です。「より高速なGPUを作る」競争だけでなく、「より高速にGPUを設計できる企業になる」競争が始まっているとも言えるでしょう。
🏭 Vera Rubinから次世代「Rosa」へ、NVIDIAがCPUまで自社設計する狙い
Veraは単独CPUとしてだけでなく、Rubin GPUと組み合わせた「Vera Rubin」プラットフォームの中核でもあります。Vera Rubin NVL72では36基のVera CPUと72基のRubin GPUをラック単位で統合し、CPU側だけでも合計3,168基のOlympusコアを搭載します。2026年7月にはCoreWeave、Google Cloud、Microsoft Azure、Oracle Cloud Infrastructure、NebiusなどでVera Rubinシステムの展開が進んでいることもNVIDIAから明らかにされました。NVIDIAはもはやGPU単体を販売する会社というより、CPU、GPU、NVLink、ネットワーク、DPU、ラック、ソフトウェアまでAIデータセンター全体を設計する企業へ変化しています。
そしてVeraの先には、独自「Rigel」コアを採用する次世代「Rosa CPU」が計画されています。NVIDIAはVeraで得られた知見を次世代CPUへ反映するとともに、主要EDAアプリケーションの最適化もCPUロードマップ全体で継続する方針です。この循環は非常に興味深く、Veraで次世代GPU・CPUを設計し、その次世代CPUがさらに次の半導体設計を高速化するという構造になります。AIによるEDA最適化やGPUアクセラレーションも組み合わせれば、将来的には半導体企業の競争力を「チップそのものの性能」だけではなく、「1年間にどれだけ多くの設計を試せるか」という開発速度が左右する可能性があります。
📌 まとめ:Veraの本当の価値は「次のNVIDIAを作る速度」にある
Vera CPUのEDA処理が最大1.5倍高速化したという数字はもちろん重要ですが、より大きな意味を持つのは、NVIDIAが自社CPUを次世代CPU・GPU開発の道具として利用し始めたことです。88基の独自Olympusコア、高いシングルスレッド性能、最大1.2TB/sのメモリ帯域、Rubin GPUとの高速接続を組み合わせることで、AI処理だけでなく半導体設計そのものを高速化します。Vera → Rubin → Rosa、さらにその先へと開発サイクルが続けば、NVIDIAにとってCPU事業は単なる新しい製品カテゴリーではなく、次世代AI半導体をより速く生み出すための戦略的な基盤になっていきそうです。
📚 参考・出典
- NVIDIA Blog「NVIDIA Harnesses Vera CPU to Speed Up Design of Next-Generation CPUs and GPUs」
- NVIDIA「Vera CPU」製品情報
- NVIDIA Newsroom「NVIDIA Unveils Vera, the CPU for Agents」
- NVIDIA Technical Blog「Vera CPU Boosts AI Factory Throughput」
- NVIDIA Technical Blog「Olympus Cores Built for Maximum Single-Threaded Performance」
- NVIDIA「Vera Rubin NVL72」製品情報
- NVIDIA Blog「Vera Rubin Driving Performance Per Watt」