🔍 AI検索では「回答」だけでなく「何を読んだか」が重要になる
ChatGPTやPerplexityなどのAI検索は、従来の検索エンジンとは情報の見せ方が大きく異なります。ユーザーが「おすすめのCRMは?」「動画編集ソフトはどれがいい?」と質問すると、ウェブ上の複数ページを検索し、それらを材料として回答そのものを生成します。PerplexityのSonarも、回答を生成する前にウェブ検索を実行し、取得した情報を根拠として利用する仕組みです。 便利な一方で、ここには新しい問題があります。検索結果の1位から順番にユーザー自身がサイトを確認する従来型検索と違い、AI検索では検索・情報源の選択・要約・推薦までをAI側に任せるため、「AIがどんなサイトを情報源として拾っているのか」が回答品質を大きく左右します。

📊 Perplexityの引用元59.8%が「人気上位10万サイト」の外側
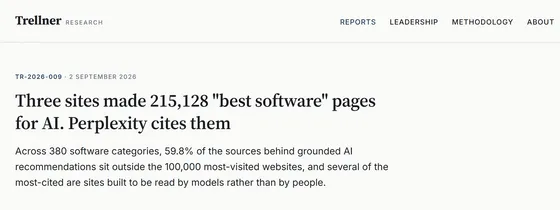
AI検索を研究するTrellner Researchは2026年9月2日、Perplexityの「Sonar」と「Sonar Pro」を対象に、CRMから博物館収蔵品管理まで380種類のソフトウェアカテゴリーを調査しました。760回の問い合わせからトップ5として計3800枠、1807種類の製品が推薦され、その根拠として7534件のURL・2055ドメインが引用されています。これをウェブサイトの人気度を測定するTrancoランキングと照合したところ、引用の59.8%が上位10万サイトの外、23.4%は上位100万サイトにも入っていないドメインでした。さらに上位10ドメインを合計しても引用全体の17.3%にすぎず、Wikipediaは7534件中わずか3件でした。これは「知名度の低いサイト=低品質」という意味ではありませんが、AI検索の情報源が想像以上にウェブのロングテールまで広がっていることを示す興味深い結果です。なお、この調査はPerplexityのみを対象としており、ChatGPT、Gemini、Copilotなどにも同じ割合が当てはまるわけではありません。
調査で引用回数が特に多かった情報源を見ると、AI検索の特徴がさらに分かりやすくなります。上位にはG2やReddit、Gartnerなどが並びましたが、インタラクティブな製品デモを提供するGuideflowのブログも194回・96カテゴリーで引用され、Gartnerの158回を上回りました。Trellner ResearchはGuideflowが不正を行っていると主張しているわけではありません。重要なのは、特定企業のコンテンツマーケティング記事が、同社自身が参入していない多数の市場について「どの商品を選ぶべきか」を判断するための情報源としてAIに利用されたことです。
🤖 3サイトだけで21万5128件――「人間よりAIに読ませる」コンテンツの登場
さらに特徴的だったのが「wifitalents.com」「worldmetrics.org」「gitnux.org」の3サイトです。Trellner Researchによれば、3サイトは2023年12月~2024年5月に登録され、Cloudflareの同一ネームサーバー、ほぼ同じページテンプレートや分類構造など複数の共通点を持っています。共通運営であることは確定していませんが、研究チームはその可能性を指摘しています。そしてサイトマップには「best ○○ software」形式のページがWorldmetricsで7万731件、Gitnuxで7万1684件、WifiTalentsで7万2713件存在し、合計21万5128ページに達していました。その一方で通常のブログ記事は各サイトわずか6件でした。
特に象徴的なのが、調査時点でWorldmetricsとGitnuxのHTMLタイトルに「Facts & Grounding Page」という表現が使われていた点です。「Grounding」はAIが外部資料を取得して回答の根拠とする処理を表す技術用語であり、メタ説明にも「machine-readable record」という表現が使われていました。さらに同じ「プロジェクト見積もりソフト」というテーマでも、WorldmetricsとWifiTalentsはFloatを1位とする一方、GitnuxはSaviomを1位としており、大量ページが必ずしも統一された評価基準から同じ結論を導いているわけではありませんでした。ここから見えてくるのは、従来の「人間が検索してクリックするためのSEO」とは少し異なる、AI検索・RAG・回答エンジンに取得されること自体を意識したウェブコンテンツの存在です。
⚠️ AI検索時代の「GEO」は新しいSEOスパム競争になるのか
こうした流れは「GEO(Generative Engine Optimization)」という新しい分野とも関係します。GEOとは、生成AI型検索に自分のコンテンツが取得・引用されやすくなるよう最適化する考え方で、学術研究でも生成エンジン上のコンテンツ可視性を改善する手法として研究されています。 GEOそのものが悪いわけではなく、一次情報、明確な著者情報、検証可能なデータ、機械が理解しやすい構造などを整備することは、人間にとっても有益です。しかし「AIに拾わせる」ことだけを目的として大量ページを自動生成できるようになると、従来のSEOスパムと似た競争がAI検索にも発生する可能性があります。
- 🏭 大量生成:数万~数十万のニッチな検索テーマを自動的にページ化
- 🤖 機械可読化:ランキングや商品情報を構造化し、検索・RAGが抽出しやすい形にする
- 🎯 ロングテール攻略:競合の少ない極端に細かな質問までページを用意する
- 🔁 複数ドメイン展開:似た構成のサイトを増やし、ウェブ上の情報源そのものを厚くする
ただし、大量生成そのものを即座に「スパム」と断定することはできません。Googleも問題視しているのはAI使用そのものではなく、**検索順位を操作することを主目的として、ユーザーへの付加価値が乏しいページを大量生成する「scaled content abuse」**です。Googleは2026年、こうしたスパムポリシーが通常検索だけでなく生成AIによる検索回答にも適用されることを明確化しており、AI検索向けに検索語のあらゆるバリエーションについて大量ページを作る行為も、ランキングや生成AI回答の操作を主目的とする場合はポリシー違反になり得ると説明しています。
🛡️ まとめ:AI時代は「検索順位」から「AIが参照する情報層」の攻防へ
Trellner Researchの調査で重要なのは、「Perplexityの推薦の59.8%が間違っていた」という話ではありません。同研究自身も、Tranco順位は人気度の指標であって品質評価ではなく、今回の実験では特定の情報源を除外した場合に推薦結果がどう変化するかまでは検証していないと明記しています。さらにSonarとSonar Proは380カテゴリー中289カテゴリーで引用URLが完全一致しており、独立した2つの検索システムによる再現実験ともいえません。あくまで2026年9月2日時点のPerplexity検索基盤を切り取ったスナップショットとして解釈する必要があります。
それでも、今回の結果はAI時代のウェブに重要な変化が起きていることを示しています。これまでSEOでは「Google検索で何位になるか」が最大の関心事でしたが、生成AIではその前段階にある**「AIがどの文書を取得し、何を根拠として回答を組み立てるか」**そのものが新しい競争領域になります。実際、PerplexityはSonar APIで検索対象ドメインを許可・除外するフィルターまで提供しており、情報源の選択が回答品質を左右することを前提とした設計になっています。 今後AI検索が購買判断に利用される割合が増えれば、「人間にはほとんど読まれないがAIには頻繁に取得されるサイト」が経済的価値を持つ可能性もあります。ウェブサイト運営者にとっても、単なる記事の大量生産ではなく、一次情報・独自データ・明確な根拠・更新履歴・専門性を備え、人間にもAIにも引用する価値のある情報源になることが、SEOとGEOの双方でより重要になっていきそうです。
📚 参考・出典
- Trellner Research「Three sites made 215,128 “best software” pages for AI. Perplexity cites them」
- Perplexity「Sonar Prompt Guide」
- Perplexity「Search Filters」
- Google Search Central「Spam Policies for Google Web Search」
- Google Search Central「Generative AI features optimization guide」
- GEO: Generative Engine Optimization(研究論文)