🖥️ 余っているPCを「個人用AIデータセンター」に変えるNVIDIA PAIR
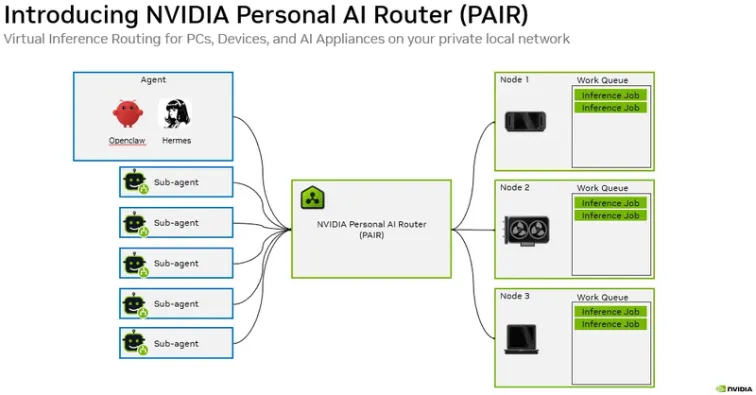
NVIDIAは2026年9月、家庭やオフィスのローカルネットワークに存在する複数のPCへAI推論を自動的に振り分ける無料のオープンソースツール「PAIR(Personal AI Router)」のベータ版を公開しました。OllamaやLM StudioでローカルLLMを動かす場合、通常はモデルを起動した1台のPCへ処理が集中します。しかしAIエージェントが複数のサブエージェントを同時に動かすようになると、GPUへ複数の推論要求が殺到し、1台の高性能GPUがボトルネックになりがちです。PAIRはネットワーク内にあるRTX搭載PC、RTX PROワークステーション、DGX Spark、対応するApple Silicon搭載Macなどを検出し、それぞれのPCが持つモデルやGPU負荷を確認しながら、**独立した推論リクエストを空いているマシンへ自動的に振り分ける「AI用ロードバランサー」**として機能します。Windows、Linux、macOSを混在させた構成も可能で、NVIDIAはこれを家庭内にある計算資源をまとめて活用するための「Virtual Inference Router」と位置づけています。
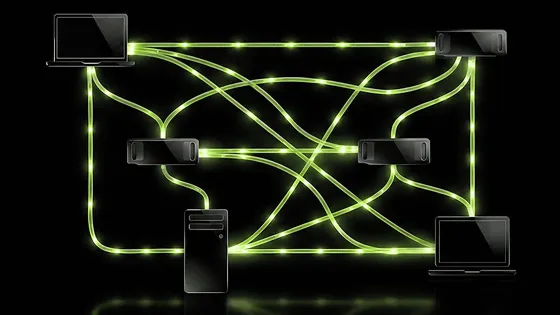
仕組みは比較的シンプルです。各PCへPAIRを導入するとmDNSを使ってLAN内の対応ノードを発見し、6桁のPINでユーザーが接続を承認します。接続後のノード間通信は相互TLS(mTLS)で暗号化され、PAIRは各ノードについて「OllamaかLM Studioが動いているか」「要求されたモデルを持っているか」「現在どれくらい負荷がかかっているか」などを確認して送信先を決定します。さらにPAIR自身がOllamaやLM Studioのインストールやモデルのダウンロードを支援でき、既存のOllama互換APIやOpenAI互換APIを利用できるため、対応アプリ側をPAIR専用に作り直す必要もほとんどありません。普段使っているエージェントから見れば、従来通りローカルのAPIへリクエストを送っているだけなのに、その裏側では別のPCが推論しているという構造です。
🧠 最大のポイントは「VRAM結合」ではなく並列処理
PAIRについて特に誤解しやすいのが、複数PCのGPUを接続すると「RTX 3070の8GB+RTX 5090の32GB=40GB VRAM」のように扱えるのかという点です。PAIRはGPUメモリを統合しません。1つの巨大モデルを複数PCへ分割して実行する分散推論システムでもありません。 1件の推論リクエストは必ず1台のノードで処理され、そのモデルを実行できるだけのVRAMまたはメモリが、そのノード単体に必要です。例えば70BモデルをどのPCにも単独でロードできない場合、PAIRで3台を接続しても70Bモデルが突然動くようにはなりません。ここはNVLinkやtensor parallelismなどによるモデル分割とは根本的に異なります。
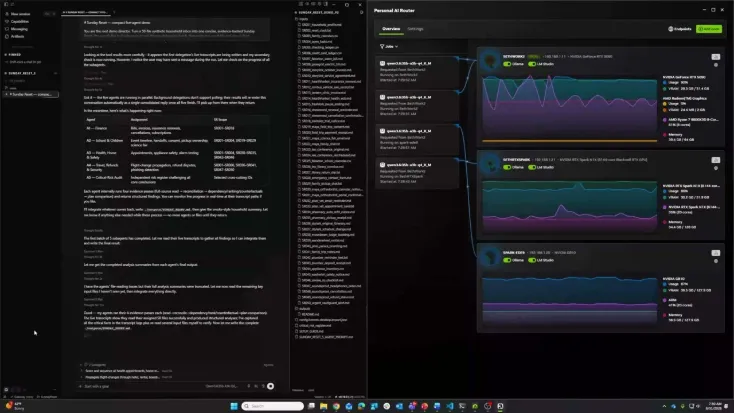
一方で、複数の仕事を同時に処理する場合には大きな効果があります。例えば5つのサブエージェントが「Web調査」「コード生成」「文章要約」「データ分析」「検証」を同時に要求した場合、それぞれを別のPCへ割り振れるためです。さらに全ノードへ同じモデルを入れる必要もなく、「PC AにはQwen」「PC BにはLlama」「PC Cには別モデル」と配置しておけば、PAIRは要求されたモデルを持つノードへルーティングできます。同じモデルを複数台へ入れておけば、そのモデルに対する同時リクエストを処理できるノードの候補が増えます。つまりPAIRの本質は「複数GPUを1枚の巨大GPUにする」のではなく、家庭内に散らばったAIマシンを1つの推論サービス群として管理することにあります。
PAIRでできること・できないことを整理すると、次のようになります。
- ✅ 複数PCへ独立したAI推論を自動分散
- ✅ Ollama・LM Studioをそのまま利用
- ✅ Windows・Linux・macOSを混在可能
- ✅ PCごとに異なるモデルを配置可能
- ✅ 同じモデルを複数台へ配置して同時処理能力を拡大
- ✅ GPUを持たないクライアントPCから別ノードのGPUを利用する構成も可能
- 🔒 ペアリング後のノード間通信はmTLSで暗号化
- ❌ 複数PCのVRAM容量を合算することはできない
- ❌ 1つの推論リクエストを複数PCへ分割して高速化する仕組みではない
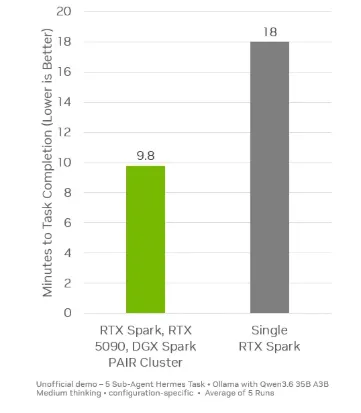
🚀 3台構成では18分→8分48秒、マルチエージェントとの相性が大きい
NVIDIAはPAIRの効果を示すため、Hermes DesktopとOllamaを組み合わせ、5つのサブエージェントを同時実行するデモを公開しています。Qwen 3.6-35B-A3Bを使ったテストでは、RTX Spark搭載PC単体の場合、ワークロード完了まで平均18分かかったのに対し、RTX Spark搭載PC、DGX Spark、GeForce RTX 5090搭載PCの3台をPAIRで接続すると平均8分48秒まで短縮されました。単純計算では処理時間を約51%削減したことになります。ただし、これは1つの推論速度が2倍になったわけではなく、複数のサブエージェントが発生させる独立した処理を3台へ並列に流した結果です。そのため、チャットを1件ずつ実行する用途より、複数のAIが同時に動くエージェントシステムほどPAIRの恩恵が大きくなります。
これは今後のローカルAI環境を考えるうえで重要な変化です。これまでは「AI専用PCを作るなら最も高性能なGPUを1枚買う」という発想が中心でしたが、PAIRでは世代やOSの異なる既存マシンを役割別のノードとして再利用できます。例えばメインPCでは画像生成や通常作業を続けながら、サブPCで文章生成、別のワークステーションで大きなLLMを動かすといった構成が考えられます。AIエージェント側はPAIRのローカルエンドポイントだけを見ればよいため、将来的にPCを追加・交換してもエージェントの構成を大きく変更せず計算資源を増やせるのも利点です。The Vergeはこうした仕組みを、使われていないPCを束ねて**「personal AI data center」へ変えるもの**と表現しています。
🔐 ローカルAIの利点を維持しつつ、安全なネットワーク設計も重視
PAIRはクラウドへ処理を送ることを前提としておらず、アプリ、モデル、推論エンジン、参加PCがすべてローカルにある構成なら、プロンプトと応答をLAN内に維持できます。また、外部アプリが接続するPAIRの推論エンドポイントは原則として127.0.0.1のループバックに限定され、別PCから直接アクセスしようとすると拒否されます。AIアプリを動かすPC自身にもPAIRを導入し、そのPCをクラスターへ参加させる方式を採用することで、推論APIを不用意にLAN全体へ公開しない設計になっています。ノード同士は6桁PINで承認した後、証明書を生成してmTLSで通信します。家庭内LANだから無条件に信用するのではなく、明示的にペアリングされたPCだけをAIクラスターへ参加させる「ゼロトラスト寄り」の設計になっている点もPAIRの特徴です。
対応環境については、NVIDIAの最新ドキュメントではWindows 11、Linux、macOSをサポートし、NVIDIA側ではGeForce RTX 20シリーズ以降、Turing世代以降のRTX PRO、DGX Sparkなどが対象です。Apple側ではM4以降のMacも対応ノードとして案内されています。GUIだけでなくターミナルインターフェースも用意されているため、ディスプレイを接続しないヘッドレスAIサーバーをSSH経由でPAIRノードとして運用することも可能です。なお、元記事にある「Ubuntu 14.04」という表記は現在のNVIDIA公式ドキュメントでは確認できず、公式資料ではより広く「Linux」と案内されています。PAIRはまだベータ版であるため、対応OSやハードウェア、エンジンなどは今後変更・拡張される可能性があります。
🔎 まとめ:PAIRが変えるのは「最強の1台」ではなく「複数PCをどう使うか」
NVIDIA PAIRの面白さは、GPU性能そのものを高める技術ではなく、これまで独立していた複数のPCを1つのローカルAI基盤として扱いやすくしたことにあります。RTX搭載PCやMac、DGX Sparkなどへ独立した推論を振り分け、OllamaやLM Studioとの互換性を維持したままマルチエージェントを並列化できます。一方でVRAMを合算したり、1つの巨大モデルを複数PCへ分割したりする技術ではないため、「小容量GPUを何枚も集めれば巨大LLMが動く」というものではありません。それでも、家庭や小規模オフィスに複数のGPU搭載PCが存在する場合には、眠っている計算資源をAIエージェントへ割り当てる有力な選択肢です。今後ローカルAIが「1人と1つのLLM」から「複数エージェントが同時に働く環境」へ移行するほど、PAIRのような個人向けAIオーケストレーション層の重要性は高まっていきそうです。
📚 参考・出典
・NVIDIA Technical Blog「NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network」
NVIDIA Technical Blog
・NVIDIA「Install and Use NVIDIA PAIR」
NVIDIA PAIR公式セットアップガイド
・NVIDIA「Personal AI Router Documentation」
NVIDIA PAIR公式ドキュメント
・NVIDIA「Getting Started」
NVIDIA PAIR Getting Started
・NVIDIA「Managing Engines」
NVIDIA PAIR Engine Lifecycle
・NVIDIA「PAIR Terminal Setup」
NVIDIA PAIR ヘッドレス・ターミナル設定
・The Verge「Nvidia launches free tool that links idle computers into a personal AI data center」
The Vergeの記事