OpenAIが、2026年7月9日に発表した高性能AIモデル「GPT-5.6」を活用し、AI自身の実行効率を改善することに成功したと明らかにしました。7月29日に公開された技術報告によると、最上位モデル「GPT-5.6 Sol」が自らGPU向けプログラムの最適化や推論高速化技術の改良に取り組み、AIサービスの提供コストを20%削減し、トークン生成効率を15%以上向上させたといいます。さらに、CodexやChatGPT Workを動かす「エージェントハーネス」も改善され、不要な処理や繰り返しの計算を削減。AIが人間の開発者を支援するだけでなく、AI自身を動かすシステムの改良にも直接貢献するという、AI開発の新たな段階が見えてきました。
🚀 ① GPT-5.6が自分自身を最適化!AI開発の新たな進化とは?
OpenAIが発表したGPT-5.6シリーズは、高性能な「GPT-5.6 Sol」、性能とコストのバランスを重視した「GPT-5.6 Terra」、低価格で高速な「GPT-5.6 Luna」の3種類で構成されています。OpenAIによると、GPT-5.6 Solは最大推論設定において、コーディング能力を測定するArtificial Analysis Coding Agent Indexで競合モデル「Claude Fable 5」を上回りながら、半分以下のコストを実現しました。また、Terraは従来のGPT-5.5と同程度の知能ベンチマーク性能を約半分の価格で提供し、LunaはSolより80%安い価格設定となっています。こうした効率化の背景には、モデルの学習方法だけでなく、GPUの処理、メモリ管理、タスクの実行手順まで含めたシステム全体の改善があります。
特に注目されるのが、GPT-5.6 Sol自身がCodexを通じて最適化作業に参加した点です。従来、AIモデルの推論エンジンを高速化するには、高度な専門知識を持つエンジニアがGPUの計算処理やメモリアクセスを分析し、プログラムを改良する必要がありました。しかし今回、GPT-5.6 Solは実際の運用データを分析し、非効率な処理を発見してコードを書き換え、改善案を検証する工程に貢献しています。これはAIが自らのモデルの重みを自由に変更したという意味ではなく、人間が管理する開発環境の中で、自分自身を実行するソフトウェアを自律的に最適化したという点が重要です。
⚡ ② GPUカーネルを自動最適化!推論コスト20%削減の仕組み
GPT-5.6 Solが大きな成果を上げたのが、GPU上で実行される「カーネル」と呼ばれるプログラムの最適化です。カーネルはAIモデルの行列演算などを処理する重要な部分で、GPUの計算能力を最大限に活用するためには、メモリへのアクセス回数やデータの配置、並列処理の順序などを細かく調整する必要があります。OpenAIはGPU向けプログラミング技術「Triton」と「Gluon」を活用しており、GPT-5.6 Solはこれらの言語で効率的なコードを記述できるよう訓練されています。実際の最適化では、不要なメモリ転送の削減、事前計算が可能な処理の特定、GPUの待機時間を減らす並列化などを実施。OpenAIによると、これらの改善によってエンドツーエンドのサービス提供コストが20%削減されました。
📊 GPT-5.6 Solが改善した主な処理
- 🧠 GPUカーネルの最適化: 演算処理やメモリアクセスを効率化し、サービス提供コストを20%削減
- ⚡ 投機的デコーディング: 小型モデルによる予測精度を改善し、トークン生成効率を15%以上向上
- 💾 KVキャッシュ管理: 過去の計算結果を効率的に保持・再利用し、メモリ負荷を最適化
- 🔄 ロードバランシング: GPUやサーバーへの処理の割り振りを改善し、計算資源の偏りを削減
- 🛠️ 自動実験と検証: AIが複数の改善案を生成し、性能を比較しながら最適な構成を探索
GPUの効率化は、AI企業の運用コストを下げるだけでなく、限られた計算資源でより多くの利用者にサービスを提供できるという利点があります。例えば、同じGPU設備で処理できるリクエスト数が増えれば、新たなデータセンターを建設せずにサービスの処理能力を拡大できる可能性があります。ただし、今回の20%削減はOpenAIの本番環境におけるサービス提供コストの改善であり、すべてのGPU処理が一律に20%高速化したことを意味するわけではありません。
🔬 ③ トークン生成効率15%以上向上!AIが数百回の実験を自律実行
もう一つの大きな成果が、「投機的デコーディング(Speculative Decoding)」と呼ばれる推論高速化技術の改良です。通常、大規模言語モデルは文章を生成する際、次の単語や文字に相当するトークンを順番に予測します。しかし、この方法では高性能なモデルが何度も計算を繰り返す必要があり、GPUへの負担が大きくなります。投機的デコーディングでは、比較的小さな「ドラフトモデル」が複数のトークンを先回りして予測し、メインモデルがまとめて検証することで計算効率を高めます。GPT-5.6 Solは、このドラフトモデルのサイズや構造、機能を変更する数百回の実験を自ら設計・実行し、トークン生成効率を15%以上改善しました。さらに、学習処理の起動や監視も担当し、ハードウェア障害や学習の不安定化が発生した際には自律的に介入したといいます。
こうした技術は、近年のローカルLLMや大規模AIサービスでも注目されています。特に投機的デコーディングは、予測候補を効率的に検証することで、適切な条件下では生成結果の品質を維持しながら応答速度を改善できるのが特徴です。ただし、ドラフトモデルの予測が外れると追加の処理が必要になるため、モデル同士の組み合わせや実行環境によって効果は変わります。今回の研究で重要なのは、AIが単に既存の最適化手法を適用しただけでなく、実験計画の立案から学習の監視、問題発生時の対応まで、複数の開発工程を自律的に進めたという点です。これは、AIがAI開発を支援する「AIによるAI研究」の実用性を示す具体的な事例といえます。
🛠️ ④ CodexとChatGPT Workの「ハーネス」も進化!無駄なトークンを削減
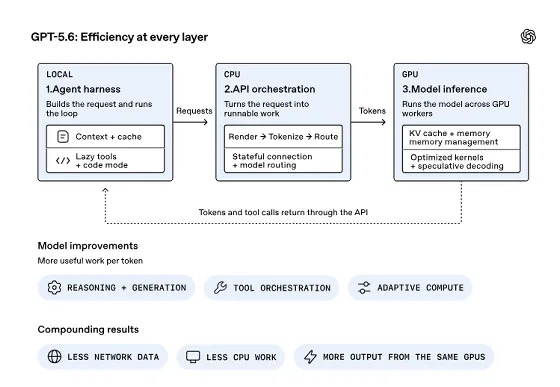
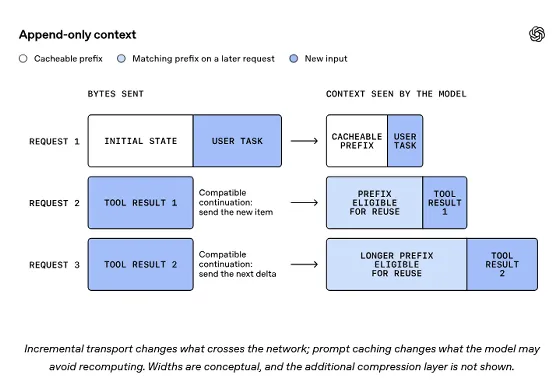
OpenAIはGPUの計算処理だけでなく、CodexやChatGPT Workで使用される「エージェントハーネス」の効率化にも取り組みました。ハーネスとは、AIモデルと外部ツール、ファイル、実行環境などを接続し、複雑なタスクを進めるための制御システムです。例えば、Codexがプログラムを修正する場合、ソースコードの読み込み、関連ファイルの検索、コードの編集、テストの実行といった処理を何度も繰り返します。そのたびに大量の会話履歴やツール情報を読み込むと、トークン消費量が増え、処理時間や運用コストが膨らんでしまいます。そこでOpenAIは、必要な情報だけを適切なタイミングで読み込み、同じ計算を繰り返さない仕組みを強化しました。
⚙️ エージェントハーネスの主な改善点
- 📦 ツールの遅延読み込み: MCPサーバーやスキル、プラグインを必要になったときだけ提示
- 📉 出力トークンの制限: ツールの出力を原則1万トークンに制限し、必要に応じて上限を変更
- 🧩 プロンプトキャッシュの活用: 共通する指示や履歴の計算結果を再利用
- 🔁 ツールの順序を固定: ツール定義の並びを一定に保ち、キャッシュの再利用率を改善
- 📝 履歴の追記方式: 過去の文脈を途中で書き換えず、新しい情報を末尾に追加
これらの改善は、特に長時間動作するAIエージェントで大きな効果を発揮すると考えられます。例えば、1回の作業で30回のモデル呼び出しが発生する場合、それぞれの処理を1秒短縮できれば、単純計算で合計30秒の短縮につながります。また、ツールの説明文や過去の処理結果を繰り返し読み込む必要がなくなれば、トークン消費量の削減にもつながります。OpenAIは、こうしたハーネスの改善によって、モデルそのものを変更しなくてもAIエージェント全体の効率を高められると説明しています。
🌍 ⑤ まとめ:AIがAIを改善する「自己最適化」の時代へ
今回の発表は、AIの進化がモデルの大型化や学習データの増加だけでなく、AI自身が開発や運用の効率化に参加する方向へ進んでいることを示しています。GPT-5.6 SolはGPUカーネルの書き換え、ドラフトモデルの改善、計算資源の管理などに貢献し、サービス提供コスト20%削減とトークン生成効率15%以上向上という成果につなげました。ただし、これは人間の管理を離れてAIが無制限に自己進化したという意味ではなく、検証ツールや開発者による管理を伴う最適化です。今後、こうした技術がさらに発展すれば、限られたGPU資源でも高性能なAIを低コストで提供できるようになり、AIサービスの普及と開発速度の向上につながる可能性があります。
📚 参考・出典
– OpenAI(2026年7月29日)「How GPT-5.6 fuses frontier intelligence with frontier efficiency」 https://openai.com/index/gpt-5-6-frontier-intelligence-efficiency/
– OpenAI「GPT-5.6: Frontier intelligence that scales with your ambition」 https://openai.com/index/gpt-5-6/
– OpenAI「Advancing the price-performance frontier with GPT-5.6」 https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
– Triton公式サイト「Triton GPU Programming」 https://triton-lang.org/
– OpenAI公式GitHub「Triton」 https://github.com/triton-lang/triton