OpenAIは、音声認識に特化した新たなAIモデル「GPT Transcribe」と「GPT Live Transcribe」を公開しました。録音済みの音声を高精度にテキスト化するモデルと、会話をリアルタイムで文字起こしするモデルの2種類が用意されており、専門用語が多い会話や周囲に雑音がある環境でも、文脈を考慮した音声認識が可能とされています。従来の音声認識AI「Whisper」シリーズと比較して認識精度が改善されたとOpenAIは説明しており、会議の議事録作成、動画字幕の自動生成、インタビューの記録、リアルタイム字幕など、幅広い用途への活用が期待されています。両モデルはOpenAI APIを通じて利用でき、音声AIを活用したアプリケーション開発の選択肢がさらに広がることになります。
🧠 GPT Transcribeとは?Whisperを上回る高精度な文字起こしAI
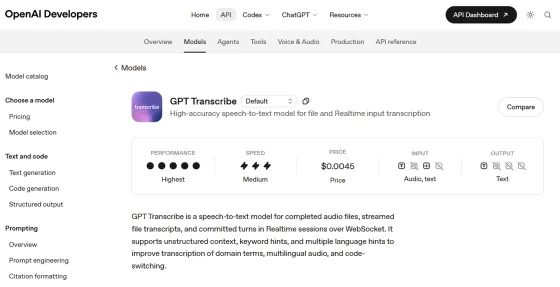
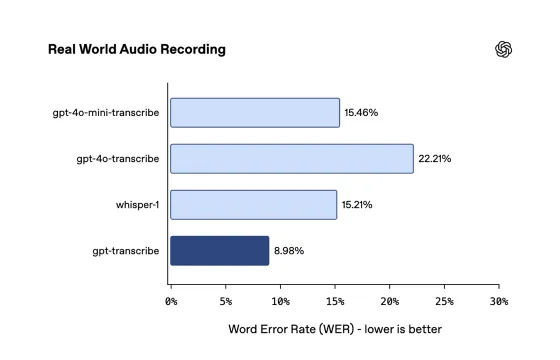
「GPT Transcribe」は、録音済みの音声ファイルをテキストに変換することを目的とした音声認識モデルです。従来のWhisperが幅広い言語の音声認識を実現したのに対し、新モデルでは会話の前後関係や専門用語を考慮する能力が強化され、聞き間違いや誤変換の削減が図られています。OpenAIが公開したベンチマークでは、従来の「whisper-1」より低い単語誤り率(WER)を記録しており、文字起こしの正確性が向上したとされています。ただし、WERは単語の置換・脱落・挿入の割合を評価する指標であり、固有名詞や数字を必ず正確に認識できることを保証するものではありません。特に日本語では、漢字表記や専門用語の変換に注意が必要です。API料金は音声1分当たり0.0045ドルで、1時間の音声を処理した場合は約0.27ドルとなり、長時間の会議やインタビューを大量に文字起こしする用途でも利用しやすい価格設定です。
⚡ GPT Live Transcribeはリアルタイム対応!会議や配信の字幕生成に活用
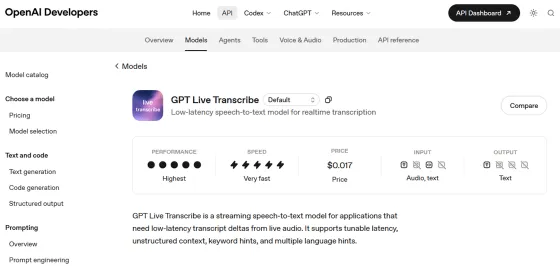
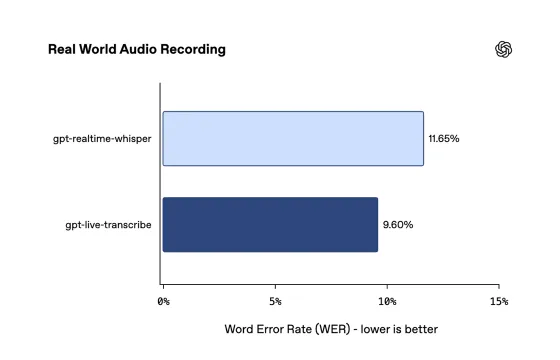
一方の「GPT Live Transcribe」は、マイクなどから入力される音声をリアルタイムで認識し、発話と並行してテキストを生成するモデルです。録音終了後にまとめて処理するGPT Transcribeとは異なり、音声を連続的に受け取りながら文字起こしできるため、オンライン会議、ライブ配信、講演会、カスタマーサポートなどへの組み込みが想定されています。OpenAIによると、2026年5月に公開された「gpt-realtime-whisper」と比較して単語誤り率が改善されており、楽器の演奏音が重なる環境でも音声を認識するデモが紹介されています。料金は音声1分当たり0.017ドルで、1時間当たり約1.02ドルです。録音済み音声の処理より料金は高くなりますが、発話と字幕表示の時間差を抑えられることが特徴です。ただし、実際の遅延はネットワーク環境や音声の区切り方、アプリケーション側の実装にも左右されます。
💰 料金と性能を比較!録音済み音声とリアルタイム処理はどちらを選ぶべき?
2つのモデルは、同じ音声認識AIでも処理方法と料金体系が異なります。すでに録音した音声をまとめて文字起こしする場合はGPT Transcribe、会話中に字幕を表示したい場合はGPT Live Transcribeが適しています。公開されている料金を比較すると、リアルタイム処理モデルは録音済み音声向けモデルの約3.8倍となりますが、リアルタイム性そのものが必要なサービスでは十分に選択肢となるでしょう。なお、以下は音声処理にかかるモデル利用料金の目安であり、別途利用する要約AI、翻訳AI、サーバー、音声保存などの費用は含まれていません。
📊 GPT TranscribeとGPT Live Transcribeの比較
| 比較項目 | GPT Transcribe | GPT Live Transcribe |
|---|---|---|
| 主な用途 | 録音済み音声の文字起こし | リアルタイム文字起こし |
| 処理方式 | ファイル入力 | ストリーミング入力 |
| 1分当たりの料金 | 0.0045ドル | 0.017ドル |
| 30分の料金目安 | 0.135ドル | 0.51ドル |
| 1時間の料金目安 | 0.27ドル | 1.02ドル |
| 比較対象の旧モデル | whisper-1 | gpt-realtime-whisper |
| 適した利用シーン | 議事録・動画字幕・取材記録 | ライブ配信・会議字幕・音声入力 |
🌍 音声認識AIの競争が加速!WhisperからリアルタイムAIへの進化
音声認識技術は、OpenAIが2022年に公開したWhisperによって大きく普及しました。Whisperは多言語対応と比較的高い認識精度を備え、オープンソースモデルをローカル環境で動かせることから、動画編集や議事録作成などの分野で広く利用されています。その後、Mistral AIの「Voxtral」シリーズや、Appleのオンデバイス音声認識技術なども登場し、クラウド処理による高精度化と端末内処理によるプライバシー保護という2つの方向で開発競争が進んでいます。OpenAIの新モデルは、こうした市場で精度とリアルタイム性を強化するものです。一方、音声認識AIには発話していない言葉を生成する誤認識のリスクもあるため、医療記録や法律相談、重要な商談などで利用する際は、人間による確認が欠かせません。また、会議や通話の録音では、個人情報の取り扱いや録音に関する法令、サービスの利用規約にも配慮する必要があります。
📝 まとめ:高精度な文字起こしAIが会議・動画制作・音声サービスを変える
OpenAIの「GPT Transcribe」と「GPT Live Transcribe」は、録音済み音声の高精度な文字起こしと、リアルタイム字幕生成という異なる用途に対応した新しい音声認識AIです。従来のWhisper系モデルと比較して認識精度の改善が示されており、専門用語や雑音を含む音声の処理にも期待が高まっています。特に、低コストで大量の音声を処理できるGPT Transcribeと、会話を即座にテキスト化できるGPT Live Transcribeの登場は、議事録作成や動画編集、ライブ配信などの自動化をさらに進める可能性があります。今後は認識精度だけでなく、日本語への対応品質、処理速度、プライバシー保護、他のAIサービスとの連携が重要な比較ポイントとなるでしょう。
📚 参考・出典
- OpenAI API — Transcription(文字起こし公式ガイド)
- OpenAI API — GPT Transcribe(モデル仕様)
- OpenAI API — GPT Live Transcribe(モデル仕様)
- OpenAI API — Pricing(API料金一覧)
- OpenAI — Introducing Whisper(Whisperの技術的背景)
- Mistral AI — Voxtral(音声AIモデル)