AIモデルの性能を、単なるプログラミング能力ではなく「MCPサーバーやMCPクライアントを正しく構築できるか」という観点から評価する新たなベンチマーク「mcpbench」が公開されました。開発したのは、Cloudflareのシニアシステムエンジニアで、MCP関連の開発にも携わるMatt Carey氏です。GPT-5.6 Sol・Luna・Terra、Claude Opus 4.8、Claude Sonnet 5、Kimi K2.7 CodeなどのAIモデルを対象に、MCPの仕様に準拠したプログラムを実装できるかを比較しています。その結果、GPT-5.6 SolがMCPクライアントの構築で高い評価を獲得した一方、新しいMCP仕様では多くのモデルが苦戦し、公式ドキュメントを与えることで成績が大幅に改善することが明らかになりました。AIエージェントの普及によってMCPの重要性が高まる中、AIモデルが最新技術をどこまで正確に理解し、実装できるのかが注目されています。
🔌 ① 「mcpbench」とは?AIがMCPサーバーを構築できるかを測定する新ベンチマーク
mcpbenchは、AIモデルにMCPクライアントやMCPサーバーを実際に開発させ、その動作が公式仕様に適合しているかを評価するオープンソースのベンチマークです。MCPは「Model Context Protocol」の略称で、Anthropicが2024年11月に公開した、AIアプリケーションと外部ツール・データソースを接続するための共通規格です。例えば、AIがGitHubのリポジトリを参照したり、データベースを検索したり、外部サービスを操作したりする際に、サービスごとに異なる接続方法を統一する役割を担います。MCPでは、AIアプリケーション側で接続を管理する「クライアント」と、外部ツールやデータを提供する「サーバー」が通信する仕組みを採用しています。mcpbenchは、この両方を正しく実装できるかを検証することで、AIモデルの実用的な開発能力を評価します。
従来のプログラミング系ベンチマークでは、アルゴリズム問題を解けるか、既存のソースコードを修正できるかといった能力が重視されてきました。しかし、実際のソフトウェア開発では、APIの通信手順、認証、エラー処理、バージョン間の仕様変更など、単にコードを書くだけでは解決できない問題も数多く存在します。mcpbenchでは、こうしたMCP固有の要件について、公式ドキュメントなしで実装する「NO DOCS」と、仕様書を参照できる「FULL DOCS」の2条件を設定。AIモデルが事前学習で得た知識だけで実装できるのか、それとも外部の技術文書を読み込むことで対応できるのかを比較しています。なお、これはMCPの実装能力に特化したテストであり、AIモデル全体の知能やプログラミング性能を直接順位付けするものではありません。
📊 ② GPT-5.6 SolがMCPクライアント構築で首位!Claude OpusやKimiとの性能差は?
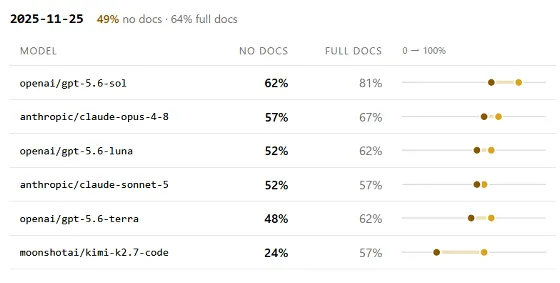
mcpbenchの結果によると、2025年11月25日版のMCP仕様に対応したクライアント構築では、GPT-5.6 SolがNO DOCSで62%、FULL DOCSで81%を記録し、比較対象の中で最高スコアとなりました。Claude Opus 4.8はNO DOCSで57%、FULL DOCSで67%となり、GPT-5.6 Solに続く成績を収めています。また、Kimi K2.7 CodeはNO DOCSで24%だったものの、FULL DOCSでは57%まで改善しており、公式仕様書の有無がAIの実装能力に大きく影響していることがわかります。
🏆 MCPクライアント構築の主なスコア(2025-11-25仕様)
| AIモデル | NO DOCS | FULL DOCS |
|---|---|---|
| GPT-5.6 Sol | 62% | 81% |
| Claude Opus 4.8 | 57% | 67% |
| GPT-5.6 Luna | 52% | 62% |
| Claude Sonnet 5 | 52% | 57% |
| GPT-5.6 Terra | 48% | 62% |
| Kimi K2.7 Code | 24% | 57% |
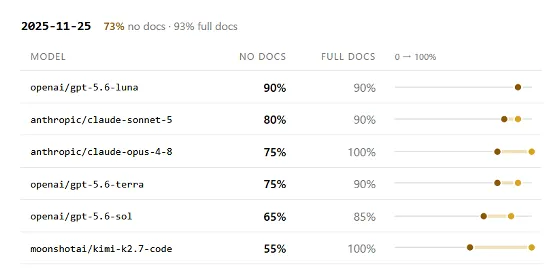
一方、MCPサーバーの構築では異なる結果が得られました。2025年11月25日版の仕様において、NO DOCSではGPT-5.6 Lunaが90%で最高スコアを記録し、Claude Sonnet 5が80%、Claude Opus 4.8とGPT-5.6 Terraが75%で続きました。FULL DOCSではClaude Opus 4.8とKimi K2.7 Codeが100%を達成しています。つまり、同じAIモデルでもクライアントとサーバーのどちらを開発するかによって得意分野が異なり、特定のモデルがすべての開発タスクで最高性能を発揮するわけではないことが示されています。
🚀 ③ MCPの新仕様「2026-07-28」でAIが苦戦!ドキュメントなしでは成功率が急落
2026年7月28日に公開されたMCPの新仕様では、通信の仕組みが大きく変更されました。従来のMCPは、クライアントとサーバーが接続時に初期化処理を行い、セッションを管理する設計でしたが、新仕様では原則として各リクエストを独立して処理する「ステートレス」方式に移行しています。これにより、サーバー側で接続状態を保持する必要が減り、クラウド環境でのスケーラビリティや負荷分散の改善が期待されています。さらに、複数回にわたるユーザーへの情報要求、非同期タスク、認証方式などにも変更が加えられました。
🛠️ MCP 2026-07-28の主な変更点
- 🔄 ステートレス化: 接続ごとの状態管理を減らし、独立したリクエスト処理を基本とする
- ⚡ 初期化フローの変更: 従来の
initialize/initializedを前提とした実装から移行 - 💬 複数ラウンドのElicitation: MCPサーバーがユーザーへ段階的に追加情報を求める仕組みを強化
- 🔐 認証の拡張: OAuth関連の仕組みやクライアント識別に関する仕様を更新
- 🧩 非同期タスクへの対応: 長時間かかる処理の進捗確認やキャンセルなどを扱う
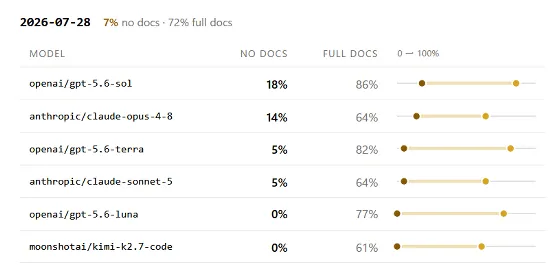
こうした仕様変更の影響で、mcpbenchの成績には大きな差が生まれました。2026年7月28日版のMCPクライアント構築では、NO DOCSの平均スコアがわずか7%に低下した一方、FULL DOCSでは72%まで回復しています。GPT-5.6 SolはNO DOCSで18%、FULL DOCSで86%を記録し、最新仕様でも最高成績を維持しました。また、GPT-5.6 Terraは5%から82%、GPT-5.6 Lunaは0%から77%へ大幅に改善しています。さらにMCPサーバー構築では、NO DOCSのスコアがすべてのモデルで0%となったものの、FULL DOCSではGPT-5.6 Solが100%、Claude Opus 4.8が94%、GPT-5.6 Lunaが89%を記録しました。この結果は、AIが新しい技術仕様を知らない場合、十分なプログラミング能力を持っていても正しい実装に失敗する可能性が高いことを示しています。
🧠 ④ AIの弱点は「知識の古さ」?RAGやCodexの開発にも重要な示唆
今回の結果で特に重要なのは、AIモデルが単純にプログラミングを苦手としているわけではなく、仕様変更によって古くなった知識に依存している可能性があるという点です。大規模言語モデルは学習時に取り込んだプログラミング知識や技術文書を基にコードを生成するため、比較的新しい規格に対しては、以前の実装方法を正しいものとして出力してしまう場合があります。今回のMCP 2026-07-28では、ステートレス方式や初期化処理の変更などが重要な違いとなっており、古いMCPの知識でプログラムを作成すると、動作自体はできても仕様に準拠していないコードになる可能性があります。mcpbenchは、このような「学習済みの知識」と「現在の技術仕様」のずれを数値化できる点で、従来のベンチマークとは異なる価値を持っています。
この傾向は、CodexやClaude Code、CursorなどのAIコーディングエージェントにも関係します。これらのツールは外部ファイルの読み込みやコマンド実行、ドキュメントの参照などを行いながら開発を進められるため、最新の公式仕様を適切に取得できれば、モデル自身が知らない技術にも対応できる可能性があります。これは外部情報を参照して回答や処理を補強する「RAG(Retrieval-Augmented Generation)」とも共通する考え方です。ただし、ドキュメントを与えるだけで必ず正しい実装ができるわけではなく、仕様書の内容を正確に解釈し、複数の要件を組み合わせ、実際の動作を検証する能力も必要になります。mcpbenchでは、AIが公式仕様書を参照した状態でも満点にならないケースが多く確認されており、ドキュメントの理解力や実装の正確性が今後の改善課題となっています。
なお、mcpbenchのスコアはテスト対象となったMCP仕様やシナリオ、モデルの設定、実行環境によって変化します。MCPのすべての機能や実際の本番運用における信頼性を網羅しているわけではありません。また、今回の比較は独立した開発者によるベンチマークであり、OpenAIやAnthropicが公式に認定した総合ランキングではない点にも注意が必要です。それでも、mcpbenchのソースコードと評価手法がGitHubで公開されていることは大きな特徴です。開発者は評価基準を確認したり、実行結果を分析したりすることで、AIモデルがどの機能で失敗しやすいのかを調べられます。今後、MCPの普及が進むほど、こうした仕様準拠性を評価するベンチマークの重要性は高まると考えられます。
🌍 ⑤ まとめ:AIによるMCP開発は「最新ドキュメントの活用」が成功の鍵
新たに公開されたベンチマーク「mcpbench」では、GPT-5.6やClaude OpusなどのAIモデルがMCPクライアント・サーバーをどの程度正しく構築できるかが比較されました。GPT-5.6 Solはクライアント構築で高い成績を収めた一方、最新のMCP 2026-07-28仕様では、すべてのモデルがドキュメントなしの実装に苦戦しています。しかし、公式仕様書を与えることでスコアが大幅に改善し、GPT-5.6 Solは新仕様のサーバー構築で100%を達成しました。今回の結果は、AIのプログラミング能力そのものだけでなく、最新の技術文書を正しく参照・理解できる環境を整えることが、AI開発の品質を左右する重要な要素であることを示しています。今後、AIエージェントがより複雑な外部サービスと連携するようになる中で、MCPへの対応力は実用的なAI開発能力を測る重要な指標となりそうです。
📚 参考・出典
– mcpbench公式サイト「Results」 https://mcpbench.mattzcarey.com/
– GitHub「mattzcarey/mcpbench」 https://github.com/mattzcarey/mcpbench
– Model Context Protocol公式仕様「Specification 2026-07-28」 https://modelcontextprotocol.io/specification/2026-07-28
– Model Context Protocol公式サイト https://modelcontextprotocol.io/
– Anthropic「Introducing the Model Context Protocol」 https://www.anthropic.com/news/model-context-protocol