中国のAI企業DeepSeekは、2026年9月10日に新たな大規模言語モデル「DeepSeek-V4.1-Flash」を公開しました。総パラメーター数5520億という巨大なモデルでありながら、推論時に必要な計算量を抑える独自の設計を採用し、高性能と低コストの両立を目指しています。公開されたベンチマークでは、Claude Opus 5やGPT-5.6 Solなどの商用AIモデルを一部の評価項目で上回ったとされ、第三者評価機関Artificial Analysisのテストでも高い評価を獲得しました。さらに、MITライセンスのオープンモデルとして公開されており、研究者や企業が独自のAIシステムに組み込める点も注目されています。AI開発の競争がモデルの性能だけでなく、運用効率や自由度へと広がる中、DeepSeekの新モデルはオープンAI市場に新たな選択肢をもたらしています。
🧠 5520億パラメーターでも高速動作!新しいMoE構造の仕組み
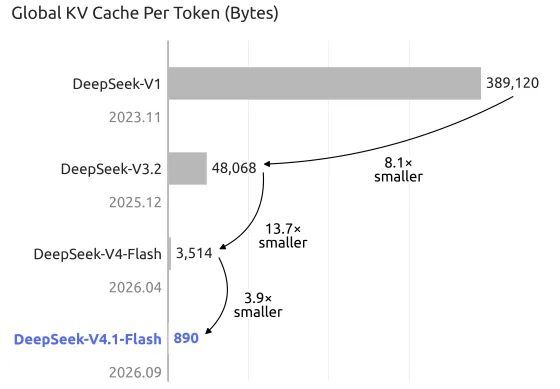
DeepSeek-V4.1-Flashの特徴は、5520億ものパラメーターを持ちながら、すべてを同時に計算する必要がない「Mixture of Experts(MoE)」構造にあります。さらに新しい「Causal Encoder–Decoder」アーキテクチャを採用し、入力処理では約80億、出力生成では約160億のパラメーターだけを活性化させる非対称設計を実現しました。これにより、大量の文書やプログラムを読み込む処理と、回答を生成する処理で計算資源を効率的に使い分けられます。また、従来のDeepSeek-V4-Flashと比較して、推論中の情報を保持するKVキャッシュの必要量を大幅に削減。GPUの高速メモリであるHBMの使用量は約4分の1、SSDストレージの使用量は約8分の1に抑えられるとしています。画像を直接理解するマルチモーダル機能にも対応しており、文章生成だけでなく、画像の内容分析や視覚情報を利用したAIエージェントにも活用できます。
📊 ClaudeやGPTを上回る項目も!第三者ベンチマークで高評価
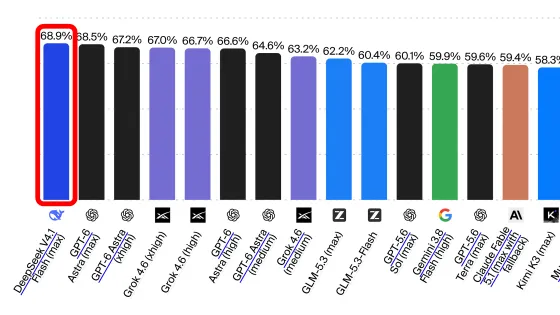
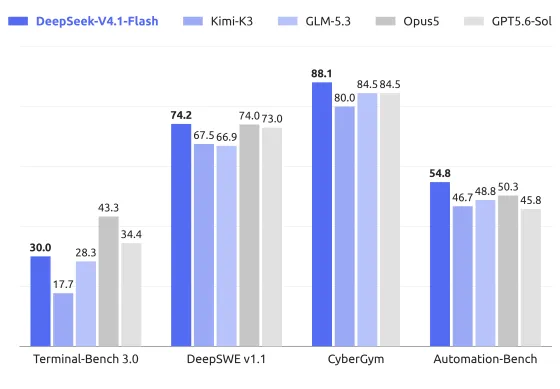
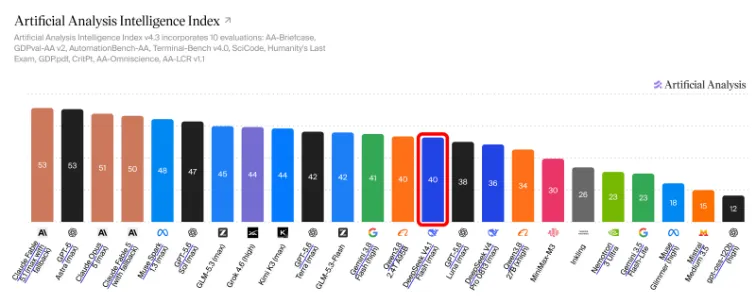
性能面では、DeepSeekが公開した評価結果に加え、第三者機関Artificial Analysisによる検証も注目されています。提供された評価情報によると、総合的なAI性能を示す「Artificial Analysis Intelligence Index v4.3」で40ポイントを記録し、GPT-5.6 Lunaを上回りました。財務・人事などの事務作業をAIが遂行する能力を測る「AutomationBench-AA」では、GPT-6 Astraを超える結果が報告されています。一方、課題解決に必要な出力トークン数は比較的多く、短い回答で効率よく問題を解くモデルと比べると、実際の運用費用が高くなる場合もあります。ベンチマークは評価条件やツールの使用方法によって順位が変動するため、Claude Opus 5やGPT-5.6 Solをすべての用途で上回るという意味ではありません。DeepSeekの公式評価でも、コーディング、数学、ツール操作、画像理解など、用途ごとに性能を比較することが重要になります。
🔍 DeepSeek-V4.1-Flashの主要スペック
- 🧠 総パラメーター数: 5520億(552B)
- ⚡ 活性化パラメーター: 入力80億/出力160億
- 🖼️ マルチモーダル: テキストと画像入力に対応
- 💾 KVキャッシュ: GPUメモリ使用量を約75%削減
- 📜 ライセンス: MIT Licenseでモデルの重みを公開
- 🏆 主な強み: AIエージェント、コーディング、長文処理、業務自動化
💰 API料金はオフピークで半額!低コスト運用を実現
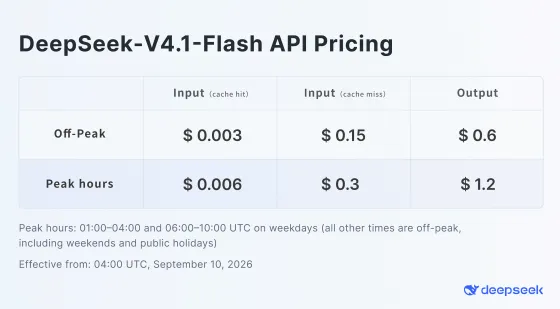
DeepSeek-V4.1-Flashは、推論効率の改善によってAPI料金も引き下げられました。料金は100万トークン当たりで設定され、利用時間帯によって価格が変化します。ピーク時間帯は通常入力が0.30ドル、キャッシュ済み入力が0.006ドル、出力が1.20ドル。オフピーク時間帯では、それぞれ半額の0.15ドル、0.003ドル、0.60ドルになります。特にキャッシュ済み入力の単価が低く設定されているため、同じ資料やプログラムを繰り返し参照するAIエージェントでは、コスト削減が期待できます。ただし、料金が安くても大量のトークンを消費すれば総費用は増えるため、実際のコスト効率はモデルの回答速度やタスク完了率も含めて評価する必要があります。なお、DeepSeekは2026年9月に旧モデルからの移行も進めており、APIでV4.1-Flashを利用する場合のモデル名は「deepseek-flash」です。
🌐 MITライセンスで無償公開!ローカルAIと企業導入への影響
DeepSeek-V4.1-FlashはHugging Faceなどでモデルの重みが公開されており、MITライセンスの条件に従って改変や商用利用も可能です。これは、API経由でしか利用できないクローズドモデルと異なり、企業が自社のサーバー上で推論環境を構築したり、独自の業務システムへ組み込んだりできることを意味します。ただし、モデルが無償公開されていることと、運用コストが無料であることは別問題です。Hugging Faceで公開されているモデル一式は約510GBに達し、一般的な家庭用GPU1枚でそのまま動作させることは現実的ではありません。量子化や分散推論によって必要なメモリを削減できる可能性はありますが、本格的な運用には大容量メモリや複数GPUなどの設備が求められます。世界的にAIモデルのオープン化が進む中、DeepSeekの取り組みは、クラウドAPIへの依存を減らしたい企業や研究機関にとって重要な選択肢となりそうです。
📝 まとめ:高性能・低価格・オープン化を両立するDeepSeekの新戦略
DeepSeek-V4.1-Flashは、5520億パラメーターの大規模モデルでありながら、MoE構造とKVキャッシュの最適化によって推論コストを抑えた新世代のAIモデルです。一部のベンチマークでは最先端の商用AIに匹敵、あるいは上回る性能を示し、画像理解やAIエージェントにも対応しています。さらに、低価格なAPIとMITライセンスによるモデル公開を組み合わせることで、クラウド利用から独自サーバーでの運用まで幅広い選択肢を提供しています。今後のAI競争では、単純な性能ランキングだけでなく、実際の作業をどれだけ低コストかつ安定して完了できるかが、モデル選択の重要な基準になりそうです。
📚 参考・出典
- DeepSeek公式 — Introducing DeepSeek-V4.1-Flash(2026年9月10日)
- DeepSeek API Docs — V4.1-Flashリリース情報
- DeepSeek API Docs — 更新履歴・ベンチマーク結果
- Hugging Face — DeepSeek-V4.1-Flash モデル公開ページ
- DeepSeek-V4.1-Flash 技術レポート(PDF)